
Inside LLMs – Grundlagen und der neuartige Ansatz von DeepSeek

👋 Willkommen an alle neuen Leserinnen und Leser!
Falls Sie neu hier sind: ThreatLink untersucht jeden Monat, wie moderne Angriffe Technologien wie LLMs, Cyberrisiken durch Drittanbieter und Abhängigkeiten in der Lieferkette ausnutzen. Alle bisherigen Artikel finden Sie hier (z. B.: Sicherheitsvorfall bei Uber und MFA-Fatigue, XZ Utils: Open Source durch Social Engineering infiltrieren).
Vielen Dank, dass Sie diesen monatlichen Newsletter unterstützen, indem Sie ihn mit Ihren Kollegen teilen
Étienne
Dieser Artikel eröffnet eine Serie über den Aufstieg neuer Anbieter von Sprachmodellen (LLMs) und die neuen Risiken, die sie mit sich bringen.
Für Cybersecurity-Teams ist es grundlegend, zu verstehen, wie diese Modelle aufgebaut sind. Noch bevor man Risiken bewertet – sei es Modellmissbrauch, Datenlecks oder adversariale Manipulation –, muss man die Prinzipien verstehen, die die Fähigkeiten und Grenzen eines LLM prägen. Das Verständnis der zugrunde liegenden Systeme ermöglicht fundiertere Überlegungen zu Bedrohungsmodellierung, Erkennungsstrategie und Governance.
Unser Ausgangspunkt: verstehen, wie diese Modelle aufgebaut sind und warum DeepSeek die Ökonomie der LLM-Entwicklung neu definieren könnte.
🔑 Kernpunkte:
LLMs entstehen in einer klar definierten, mehrstufigen Pipeline: Pre-Training, Instruction Tuning und Preference Tuning.
DeepSeek ist auf mehreren Ebenen innovativ – insbesondere durch niedrigere Kosten, effizienteres Alignment und einen Schwerpunkt auf Reasoning.
DeepSeek hat nicht nur seine Modelle als Open Source veröffentlicht, sondern auch seine Trainingsmethodik – ein starkes Signal der Transparenz, das es von vielen Wettbewerbern abhebt.
Gehostete LLM-Dienste – ob von DeepSeek (online), xAI (Grok) oder anderen – beruhen auf versteckten Pre-Prompts und Filterschichten, die echte Fragen der Data Governance aufwerfen. Diese Plattformen können von geopolitischen Faktoren oder einzelnen Persönlichkeiten beeinflusst werden:
Im Fall von DeepSeek unterliegt der Betrieb der Regulierung durch den chinesischen Staat.
Im Fall von xAI können Entscheidungen zu Alignment und Moderation von den persönlichen Ansichten Elon Musks beeinflusst werden.
Wie LLMs funktionieren: ein mehrschichtiger Prozess
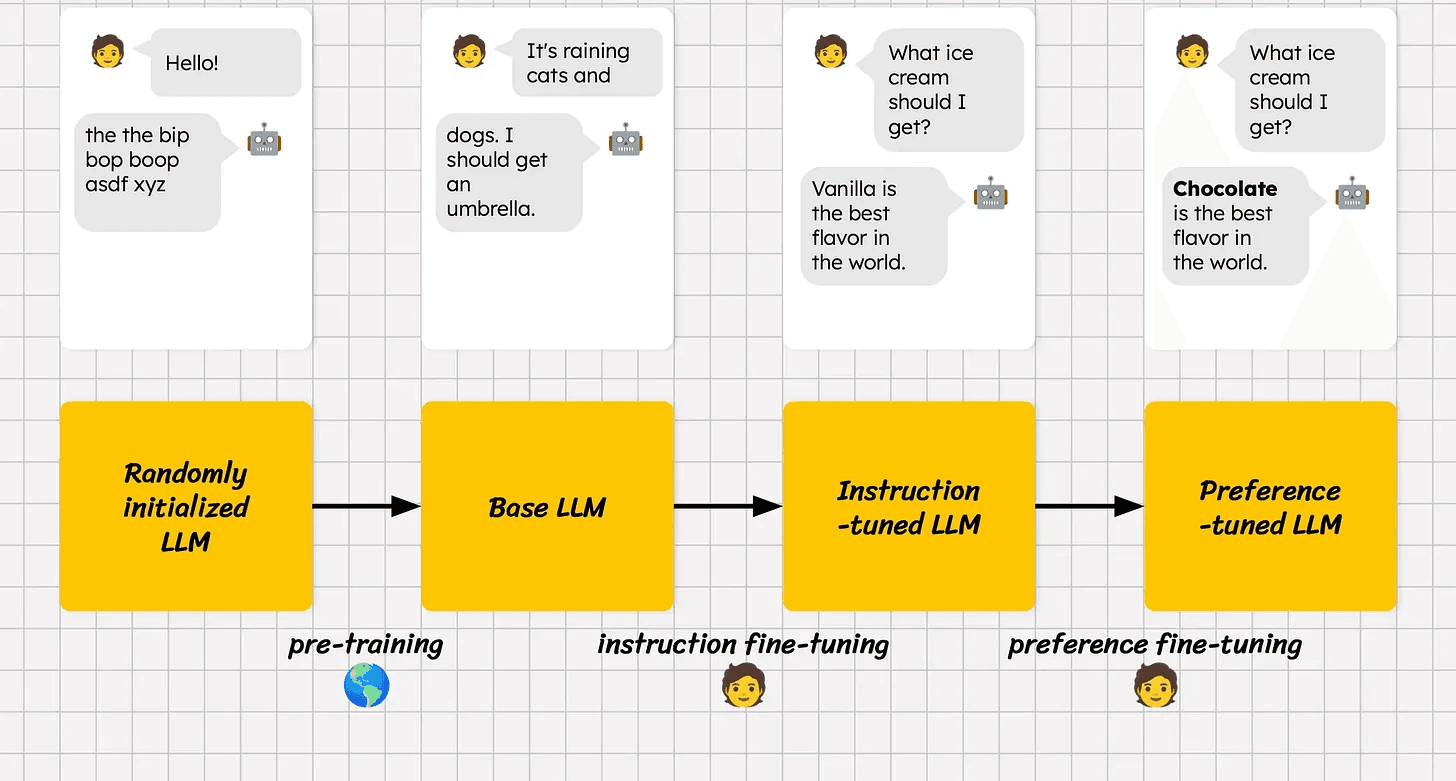
Moderne LLMs folgen einer strukturierten Entwicklungspipeline in drei Stufen:
1. Pre-Training
Ein riesiges neuronales Netz wird auf einem umfangreichen Textkorpus trainiert, um das nächste Wort in einem Satz vorherzusagen. So entsteht ein probabilistisches Sprachmodell – die Grundfähigkeit des LLM.
2. Instruction Tuning (Instruction Fine-Tuning)
Das vortrainierte Modell wird anschließend mithilfe strukturierter Frage-Antwort-Paare oder spezifischer Aufgaben verfeinert (z. B.: „Erkläre diesen Algorithmus“). Dadurch lernt das Modell, menschlichen Anweisungen zu folgen.
Open-Source-Modelle wie LLaMA oder Mistral werden häufig in diesem Stadium veröffentlicht, meist mit dem Suffix „Instruct“:
https://huggingface.co/mistralai/Mistral-Small-3.1-24B-Instruct-2503
3. Preference Tuning (Preference Fine-Tuning)
In dieser Phase beginnt das Modell, den Eindruck von Intelligenz zu vermitteln.
Menschliche Annotatoren bewerten die Antworten des Modells, anschließend wird auf Basis dieser Rangfolgen ein Belohnungsmodell trainiert. Dieses Modell dient dazu, die Antworten des LLM an menschlichen Präferenzen auszurichten.
Das war das entscheidende Element, das ChatGPT deutlich zuverlässiger machte als seine Vorgänger.
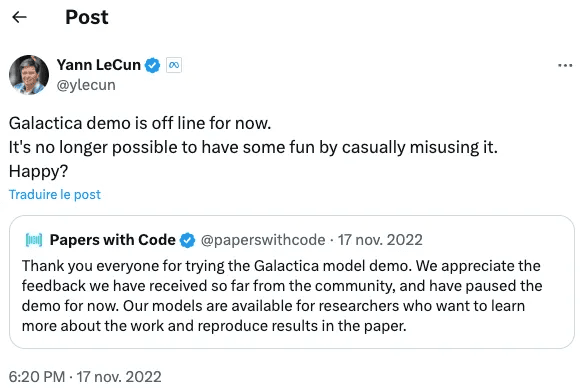
Ohne diese Phase ist es viel wahrscheinlicher, dass Modelle entgleisen – wie bei Metas Galactica, das nur zwei Wochen vor ChatGPT-3 veröffentlicht und schnell wieder zurückgezogen wurde, nachdem Trolls es zur Erzeugung von Desinformation missbraucht hatten.
DeepSeek folgt derselben grundlegenden Architektur – jedoch mit einigen entscheidenden Unterschieden.
Den Rest des Artikels finden Sie in meinem Newsletter ThreatLink hier